El seo tecnico es la parte del posicionamiento que evita que los problemas de una web oculten un buen contenido. Si una página no puede rastrearse, renderizarse o indexarse correctamente, mejorar sus textos o conseguir enlaces tendrá un efecto limitado. Yo lo abordaría como una revisión de la infraestructura que permite a los buscadores descubrir, interpretar y mostrar el sitio.
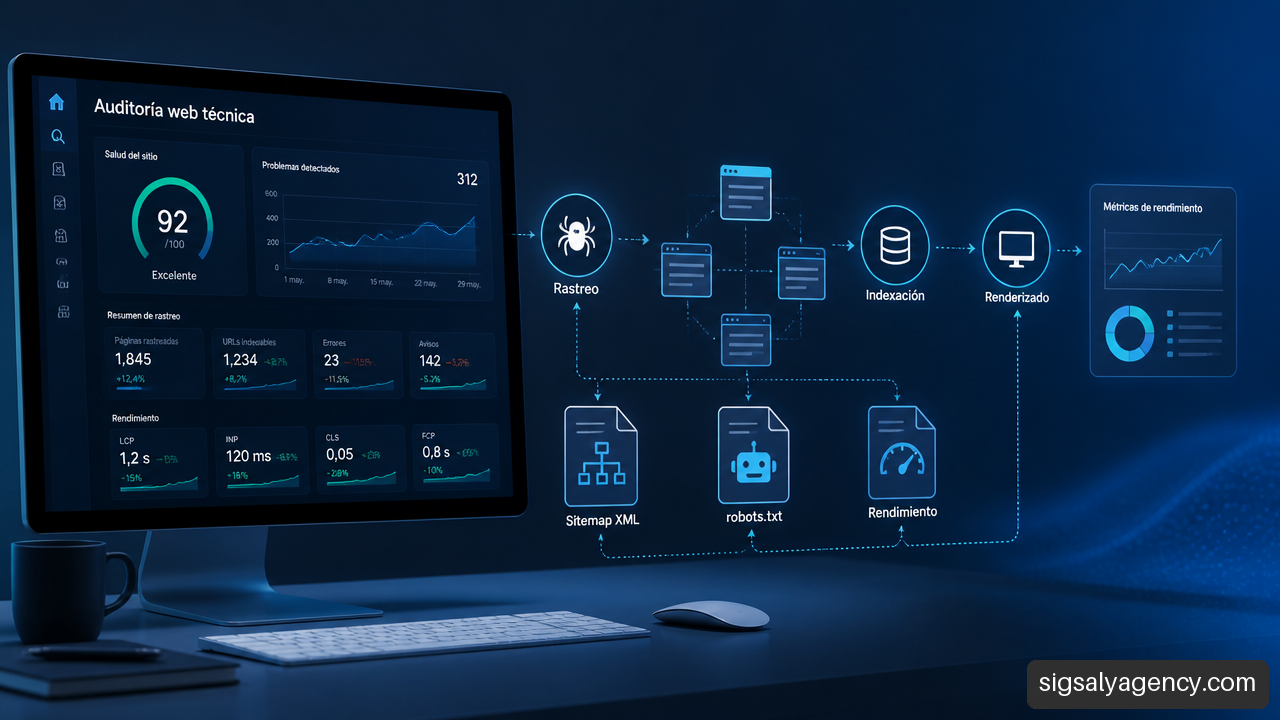
Tabla De Contenidos
• Qué Debe Resolver El SEO Técnico
• Cómo Auditar Y Priorizar Problemas Técnicos
• Implementaciones Críticas: JavaScript, Idiomas Y Migraciones
• Preguntas Frecuentes Sobre SEO Técnico
• Fuentes
Qué Debe Resolver El SEO Técnico
El seo tecnico busca que la estructura y los recursos de una web permitan a Google acceder a las URLs importantes, procesar su contenido y decidir si deben formar parte de su índice. No es una colección de ajustes aislados. Es un sistema en el que arquitectura, servidores, etiquetas, redirecciones y rendimiento se afectan entre sí.
La guía oficial de técnicas y estrategias de SEO de Google Search Central reúne prácticas para mejorar la rastreabilidad, la indexabilidad y otros fundamentos técnicos. Es una referencia útil para distinguir entre una recomendación razonable y una regla que puede impedir directamente que una URL aparezca en resultados.
Rastreo, Renderizado E Indexación No Son Lo Mismo
Conviene separar tres fases, porque cada una falla por motivos distintos:
| Fase | Qué Ocurre | Señal De Problema | Acción Principal |
|---|---|---|---|
| Rastreo | El robot solicita una URL y sus recursos | La URL no se descubre o devuelve errores | Revisar enlaces internos, sitemap, respuestas HTTP y robots.txt |
| Renderizado | Se procesan HTML, CSS, JavaScript e imágenes necesarios | El contenido final no coincide con lo que ve un usuario | Comprobar HTML renderizado y recursos bloqueados |
| Indexación | Google evalúa si conserva la URL para resultados | La URL queda excluida o se selecciona otra canónica | Revisar noindex, canonical, duplicidad y calidad de la página |
Una página puede devolver código 200 y seguir sin ser útil para SEO. Por ejemplo, una ficha de producto puede cargar para una persona, pero dejar el nombre, precio y descripción dentro de componentes JavaScript que no se entregan de forma fiable en el HTML inicial ni se representan correctamente. El resultado es una URL disponible, pero difícil de interpretar.
Google necesita acceder tanto a la página como a recursos de apoyo, incluidos CSS e imágenes, para renderizarla y evaluarla adecuadamente. Por eso, bloquear directorios de estilos o scripts en robots.txt sin analizar el efecto puede impedir que el buscador vea la composición real de la página. No recomiendo asumir que “si el texto está en pantalla, Google ya lo entiende”. Hay que validarlo con una inspección real.
Robots.txt, Noindex, Sitemap Y Canonical: Cuatro Funciones Distintas
Estos elementos se confunden con frecuencia, aunque resuelven problemas diferentes. Un error habitual es usar robots.txt para intentar retirar páginas de Google. Ese archivo orienta el rastreo, pero no equivale a una instrucción de exclusión del índice. Si una URL ya es conocida por enlaces externos u otras señales, bloquear su rastreo no garantiza que desaparezca de los resultados.
| Elemento | Función Correcta | Cuándo Usarlo | Cuándo No Basta |
|---|---|---|---|
robots.txt | Orientar el acceso de rastreadores | Rutas sin valor de rastreo, como áreas técnicas controladas | Para retirar una URL ya indexada |
noindex | Pedir que una página no se indexe | Filtros, resultados internos o contenidos de poco valor | Si la URL está bloqueada y el robot no puede leer la etiqueta |
| Sitemap XML | Facilitar el descubrimiento de URLs canónicas relevantes | Páginas nuevas, grandes catálogos y cambios frecuentes | Como sustituto de enlaces internos coherentes |
| Canonical | Señalar la versión preferida entre URLs similares | Variantes de parámetros, paginación o duplicidad controlada | Para ocultar páginas claramente innecesarias |
El canonical es una señal, no un borrador mágico. Si una tienda genera /zapatillas?color=negro, /zapatillas?orden=precio y otras combinaciones, puede indicar cuál es la URL principal. Sin embargo, si cada variante ofrece una selección realmente distinta y útil para quien busca, consolidarlas sin análisis puede reducir la cobertura de búsquedas relevantes.
La decisión depende de la intención y del contenido. Yo trataría como candidatas a consolidación las URLs con información casi idéntica, señales internas dispersas y nulo valor de entrada orgánica. En cambio, mantendría indexables las categorías que responden a una demanda específica y cuentan con navegación, inventario y contenido propios.
Arquitectura, Rendimiento Y Móvil Como Base Operativa
La arquitectura técnica distribuye autoridad interna y ayuda a descubrir páginas. Las URLs clave deberían estar accesibles desde enlaces HTML rastreables, no solo desde un buscador interno, eventos de clic o menús cargados tarde. En una web corporativa pequeña, esto suele significar servicios, sectores, casos y recursos enlazados desde rutas lógicas. En un comercio electrónico, exige controlar facetas, paginación y categorías huérfanas.
El rendimiento no debe evaluarse solo con una cifra general. Hay que identificar qué componente retrasa la carga percibida: una imagen principal demasiado pesada, fuentes bloqueantes, un script de terceros o la respuesta lenta del servidor. Las Core Web Vitals son una referencia práctica para detectar fricción, pero no sustituyen el diagnóstico de negocio. Una página rápida que no permite entender el servicio tampoco resolverá la captación.
La compatibilidad móvil merece el mismo nivel de revisión. El contenido relevante, los enlaces, los datos estructurados y las directivas deben estar presentes en la versión que recibe el usuario móvil. Ocultar información esencial en esa vista o servir una versión reducida cambia lo que el buscador puede evaluar.
En sitios construidos con gestores de contenido, la elección de plantillas, plugins y alojamiento condiciona este punto. Entender WordPress como CMS ayuda a decidir qué partes pertenecen al editor, cuáles al tema y cuáles requieren intervención técnica para no crear dependencias innecesarias.
Cómo Auditar Y Priorizar Problemas Técnicos
Una auditoría útil no empieza corrigiendo avisos por volumen. Empieza separando bloqueos reales de mejoras secundarias. Un sitio con miles de URLs no indexables y un título largo no tiene un problema de títulos: tiene un problema de descubrimiento, directivas o consolidación.
La documentación oficial de Google Search Central para mejorar SEO centraliza recursos sobre rastreo, indexación, datos estructurados, migraciones y otros temas técnicos. La usaría como base para validar configuraciones, especialmente cuando una plataforma o extensión aplica reglas automáticas difíciles de ver desde el editor.
Un Flujo De Diagnóstico Que Evita Arreglos En El Orden Equivocado
Propongo esta secuencia porque protege primero la capacidad de aparecer en buscadores y después la capacidad de competir mejor:
- Confirmar qué URLs son estratégicas. Crear una lista de páginas que deben captar visitas: servicios, categorías, fichas prioritarias, contenidos comerciales y versiones de idioma necesarias.
- Comprobar respuestas y directivas. Revisar códigos HTTP,
noindex, canonicals, redirecciones y posibles bloqueos. Una URL prioritaria con 404, 5xx, canonical hacia otra página onoindexse resuelve antes que cualquier mejora visual.
- Inspeccionar la URL en Search Console. Esta herramienta no sirve solo para enviar un sitemap. Permite comprobar la URL canónica seleccionada, el estado de indexación, la fecha de rastreo y posibles causas de exclusión. Si la página está publicada pero no aparece, este paso reduce hipótesis.
- Comparar el HTML y el resultado renderizado. En especial con JavaScript, hay que verificar que títulos, enlaces, texto principal y elementos de producto estén disponibles para el rastreador.
- Analizar plantillas y patrones. Un fallo en la plantilla de una categoría puede repetirse en cientos de URLs. Corregir el patrón tiene más impacto que editar páginas una por una.
- Optimizar rendimiento y enriquecimiento. Cuando las páginas ya son descubribles e indexables, se puede trabajar velocidad, datos estructurados y mejoras de presentación en resultados.
Regla práctica: primero resuelve lo que impide que una URL exista para Google; después, lo que dificulta su uso; por último, lo que puede enriquecer su presentación.
Search Console Como Herramienta De Diagnóstico
Search Console es especialmente valiosa cuando surge la pregunta: “¿por qué esta URL no está indexada?”. En vez de concluir que Google tarda demasiado, conviene revisar el motivo que muestra la inspección. Las causas pueden apuntar a noindex, redirección, duplicidad, bloqueo, contenido alternativo con canonical o errores de servidor.
La información debe leerse con contexto. Que una URL no esté indexada no siempre es un fallo. Un filtro de talla, una página de agradecimiento o un resultado de búsqueda interna quizá no debería competir en resultados. El problema aparece cuando la exclusión afecta a una categoría rentable, una landing de servicio o una versión lingüística imprescindible.
En sitios grandes, también observaría qué áreas reciben rastreo y cuáles se actualizan con retraso. El presupuesto de rastreo suele importar más cuando hay muchas URLs, parámetros, calendarios, filtros o inventario variable. Si el robot dedica recursos a páginas duplicadas, puede tardar más en descubrir cambios en las que realmente importan.
Qué Revisar Según El Tipo De Sitio
No todas las prioridades tienen el mismo peso. Esta tabla ayuda a decidir dónde concentrar el trabajo inicial:
| Tipo De Sitio | Riesgo Técnico Más Habitual | Prioridad Inicial | Decisión Recomendable |
|---|---|---|---|
| Ecommerce | Filtros, productos agotados y duplicidad por variantes | Canonicals, facetas, enlaces internos y sitemaps | Indexar solo combinaciones con demanda y contenido útil |
| SaaS | Contenido JavaScript y páginas de producto dinámicas | Renderizado, HTML inicial y rendimiento | Entregar contenido crítico sin depender por completo del cliente |
| Medio Digital | Archivo amplio y URLs antiguas | Arquitectura, paginación y rastreo eficiente | Facilitar descubrimiento de piezas recientes y relevantes |
| Negocio Local | Pocas páginas, pero alto valor comercial | Indexación de servicios, móvil y datos coherentes | Evitar páginas finas creadas solo para repetir localidades |
| Web Multilingüe | Versiones cruzadas y selección incorrecta de idioma | Hreflang y canonicals por idioma | Mantener correspondencia completa entre variantes |
El mantenimiento continuo permite detectar regresiones: un plugin que añade noindex, una actualización que rompe enlaces o una plantilla que cambia el canonical. Por eso, Mantenimiento web: la inversión invisible no debería entenderse como una tarea puramente operativa, sino como una medida preventiva para la visibilidad orgánica.
Implementaciones Críticas: JavaScript, Idiomas Y Migraciones
Hay configuraciones que parecen correctas hasta que se revisan en conjunto. JavaScript, hreflang y migraciones concentran algunos de los fallos más costosos porque afectan muchas URLs a la vez.
JavaScript: Contenido Visible No Siempre Significa Contenido Accesible
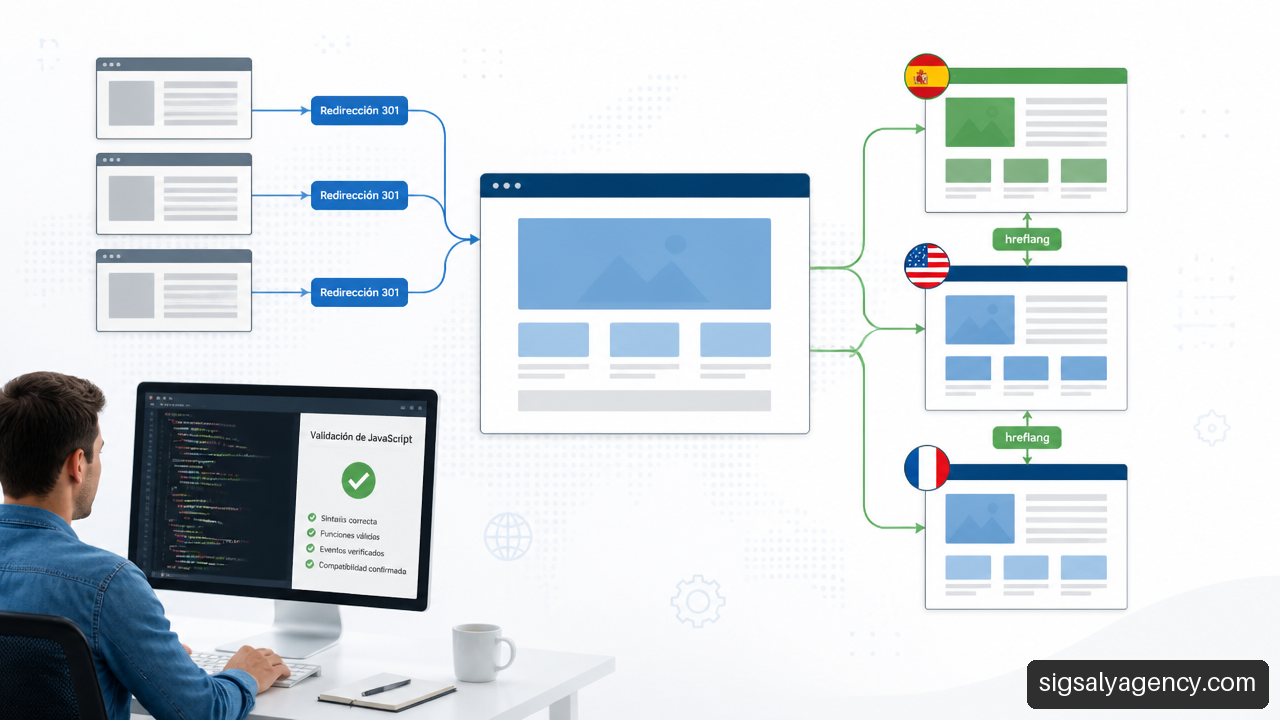
JavaScript no es incompatible con SEO técnico. El problema aparece cuando el contenido clave solo existe después de una cadena compleja de scripts, llamadas a APIs, consentimiento de cookies o interacción del usuario. Si falla una dependencia, el rastreador puede recibir una página con poco texto y pocos enlaces aunque la interfaz final parezca completa.
Para una página de servicio, los elementos críticos deberían ser accesibles sin acciones especiales:
• Título principal y descripción del servicio.
• Enlaces a servicios relacionados, casos o contacto.
• Información de precio, disponibilidad o características cuando aplique.
• Datos estructurados y metadatos coherentes con el contenido visible.
Las soluciones habituales son renderizado en servidor, prerenderizado o una arquitectura híbrida. Elegir una depende del producto y de la capacidad técnica. Para una aplicación compleja, eliminar JavaScript puede no ser realista. En ese caso, el objetivo es reducir la dependencia de JavaScript para el contenido que debe indexarse y comprobar el HTML renderizado tras cada despliegue.
Hreflang Sin Ambigüedades En Sitios Multilingües
hreflang ayuda a indicar qué URL corresponde a cada idioma o combinación de idioma y región. No traduce páginas ni sustituye una estrategia de contenido localizada. Su función es reducir la ambigüedad cuando existen alternativas equivalentes, como una página en español para España y otra para México.
Una implementación sólida debe cumplir estas condiciones:
- Cada versión debe incluir referencias a las demás versiones equivalentes.
- La relación debe ser recíproca: si la URL española declara la francesa, la francesa debe declarar la española.
- Cada página debe incluir una autorreferencia, es decir, señalar también su propia versión.
- Las URLs declaradas deben ser absolutas, indexables y devolver código 200.
- El canonical debe apuntar normalmente a la misma versión lingüística, no a una URL de otro idioma.
- La etiqueta
x-defaultresulta útil cuando existe una página de selección general o una versión destinada a usuarios sin coincidencia clara.
Un caso frecuente de error es traducir una página, pero dejar su canonical hacia el idioma original. Las señales entran en conflicto: hreflang habla de alternativas, mientras el canonical puede sugerir que una versión no es la preferida para indexar. La corrección no consiste en añadir más etiquetas, sino en definir primero qué URL debe ser autónoma e indexable en cada mercado.
Migraciones: La 301 Es Necesaria, Pero No Es Toda La Estrategia
Una migración puede incluir cambio de dominio, rediseño, HTTPS, estructura de URLs, CMS o varios cambios simultáneos. Cuantos más elementos se modifiquen a la vez, más difícil será localizar la causa de una caída. Cuando sea posible, conviene reducir variables y planificar la transición por fases.
La redirección 301 comunica que una URL se ha movido de forma permanente. Sin embargo, redirigir todo a la página de inicio no preserva la relevancia específica. La correspondencia debe ser lo más cercana posible: producto antiguo a producto equivalente, artículo antiguo a artículo actualizado y categoría anterior a categoría sucesora.
Antes de publicar, prepararía una matriz de redirecciones y validaría este recorrido:
- Exportar URLs relevantes desde analítica, enlaces internos, sitemap y rastreos previos.
- Asignar una única URL de destino válida a cada página antigua importante.
- Evitar cadenas como
A → B → C; la URL antigua debe llevar directamente al destino final.
- Actualizar enlaces internos, canonicals, hreflang y sitemaps para que apunten a las nuevas URLs.
- Mantener las redirecciones el tiempo suficiente para que usuarios, enlaces y buscadores consoliden el cambio.
- Supervisar errores de rastreo, exclusiones e impresiones después del lanzamiento.
Un rediseño puede perder tráfico no porque el diseño sea peor, sino porque se hayan eliminado textos, páginas de categoría o enlaces que sostenían la relevancia previa. La recuperación exige comparar inventario, contenido, respuestas HTTP y señales canónicas, no limitarse a esperar.
Los datos estructurados cierran este bloque con una expectativa realista: ayudan a los buscadores a comprender entidades y propiedades de una página, pero no garantizan resultados enriquecidos ni mejoras de posición. Deben reflejar información visible y válida; marcar reseñas inexistentes o precios que no aparecen en la página crea una implementación frágil.
Key Takeaways
Prioriza La Capacidad De Ser Encontrado
• Corrige antes los bloqueos de rastreo, renderizado, indexación y redirecciones que los ajustes cosméticos.
• Usa robots.txt para guiar rastreo, noindex para excluir de la indexación y canonical para consolidar alternativas similares.
• Considera Search Console un panel de diagnóstico de URLs, no solo un canal para enviar sitemaps.
Convierte El SEO Técnico En Un Proceso
• Revisa las plantillas, porque un defecto repetido tiene más impacto que un error aislado.
• Valida el contenido crítico en sitios con JavaScript y tras cada cambio relevante.
• En webs multilingües, alinea hreflang, canonicals y URLs indexables.
• En migraciones, protege las equivalencias URL a URL y evita redirecciones genéricas a la portada.
Preguntas Frecuentes Sobre SEO Técnico
¿Qué Es El SEO Técnico Exactamente?
Es el conjunto de decisiones técnicas que facilita que los buscadores descubran, rastreen, rendericen, comprendan e indexen las páginas adecuadas. Incluye arquitectura, respuestas del servidor, directivas, rendimiento, JavaScript, datos estructurados y configuraciones internacionales.
¿Cómo Sé Si Google Puede Rastrear Mi Web Correctamente?
Empieza por inspeccionar URLs prioritarias en Search Console. Después, revisa que devuelvan código 200, que no estén bloqueadas por robots.txt, que tengan enlaces internos y que sus recursos esenciales puedan cargarse. Un sitemap ayuda al descubrimiento, pero no corrige páginas inaccesibles o mal enlazadas.
¿Cómo Reviso Si Mi Sitio Está Indexado Como Debería?
Compara la lista de URLs estratégicas con los estados mostrados en Search Console. No busques indexar todo: identifica qué páginas aportan valor real y confirma que esas son las indexadas. Si Google elige otra canónica o excluye una URL, analiza la causa antes de solicitar una nueva indexación.
¿Cuándo Debo Usar Una Etiqueta Canonical?
Úsala cuando varias URLs muestran contenido idéntico o muy parecido y quieres señalar una versión preferida. Es habitual en parámetros de seguimiento, ordenaciones y variantes de navegación. No la uses para resolver páginas que deberían eliminarse, redirigirse o bloquearse de otra forma.
¿Cómo Afecta JavaScript Al SEO Técnico?
Puede retrasar o dificultar el acceso al contenido si el HTML inicial está vacío, los recursos fallan o el texto solo aparece tras una interacción. La solución depende de la tecnología, pero el contenido y enlaces clave deben poder comprobarse en el resultado renderizado por Google.
¿Cómo Configuro Hreflang En Una Web Multilingüe?
Crea relaciones entre cada grupo de páginas equivalentes por idioma o región. Incluye enlaces recíprocos, autorreferencias y URLs indexables con código 200. Evita apuntar el canonical de una versión española a la versión inglesa, porque esa combinación puede enviar señales contradictorias.
¿Qué Debo Revisar En Una Migración Web Para No Perder Tráfico?
Revisa el mapa de redirecciones 301, la equivalencia temática entre URLs antiguas y nuevas, enlaces internos, canonicals, sitemap, hreflang y respuestas del servidor. Después, controla en Search Console si aumentan errores, páginas excluidas o caídas de impresiones en áreas concretas.
Fuentes
• Google Search Central — Técnicas y estrategias de SEO: https://developers.google.com/search/docs/fundamentals/get-started?hl=es
• Google Search Central — Documentation to Improve SEO: https://developers.google.com/search/docs